把几十条商品说明分别交给 AI 整理,如果不需要立刻看到结果,就可以考虑批处理。它适合离线分类、资料清洗和评测,不适合等待即时回答的在线聊天。本文用 OpenAI Batch API 的工作方式解释 任务文件、任务编号、异步状态与结果对齐,再用纯本地 Python 练习检查乱序结果。
最终得到的不是一个“批量完成”提示,而是一份每条任务都能查到状态的清单。示例只有三条虚构任务,没有上传文件或调用付费接口;离线结果是人工构造的测试数据,不能当成真实模型运行成绩。
一、批处理与一次发很多问题有什么区别
同步调用通常是发送请求、等待响应、拿到结果后继续。批处理先把多个独立请求写进任务文件,再提交一个批次,之后查询状态、下载输出。提交成功只说明服务接受了处理请求,不代表每条内容已经生成。
把一百条问题塞进同一个长提示词,是另一种做法:问题共享同一份上下文,结果也可能混在一个回答里。Batch 中每行是一个独立请求,原有模型接口的输入约束仍然存在,不会因为放入批次就自动获得无限上下文。
也不要把批处理等同于自己开很多线程。并发请求需要管理实时限流和连接;平台批处理提供不同的异步处理机制。官方说明了批处理自己的额度和完成窗口,是否更合适还取决于任务能否等待、模型支持情况、数据政策与错误恢复成本。
二、适合哪些任务,不适合哪些任务
适合的例子包括:为一批公开文章生成待审核摘要,为虚构产品记录提出分类建议,或者对固定评测集分别生成回答。这些请求彼此独立,不要求上一条结果决定下一条输入。
不适合直接照搬的例子包括:客服必须立即回复、模型需要逐轮追问、前一步必须人工审批才能继续,以及任务需要在很短的确定时间内完成。异步处理可以降低等待期间的连接负担,却不能保证你设定的任意业务截止时间。
先用少量非敏感数据完成整条链路,再考虑增加规模。不要第一次就上传整库客户记录。文件上传、结果保留和账户权限都有独立风险,批处理不会自动替你完成脱敏和授权。
三、JSONL 的每一行是一条独立请求
官方 Batch 指南使用 .jsonl 输入:每一行都是完整 JSON 对象,不能把整个文件写成一个外层数组。每条请求有 custom_id、method、url 和 body。
custom_id是你分配的任务编号,用来找回结果,不是让模型在正文里背出来的标签。method表示请求方法;本文的 Responses 示例使用POST。url是批次中所用接口的相对路径,例如/v1/responses。body承载该接口正常需要的模型和输入参数,仍要符合接口的当前要求。
当前指南要求同一输入文件使用同一个模型。首次练习也统一使用同一接口,不把聊天、向量和图像请求拼在一个文件里,再期待平台替你分类处理。模型标识应从自己账号当前可用且支持批处理的列表确认,不盲目照搬文章里的旧名称。
下面是结构示意,MODEL_FROM_ACCOUNT 是待替换的占位符,不能直接提交:
{"custom_id":"demo-001","method":"POST","url":"/v1/responses","body":{"model":"MODEL_FROM_ACCOUNT","input":"仅将这条虚构物品归入文具或其他:蓝色铅笔"}}中文内容应以 UTF-8 保存。编辑器视觉上自动折行没有关系,实际文件中每条 JSON 仍应只占一个物理行;不要在字符串中间直接插入未转义换行。
四、从准备到取得结果的完整顺序
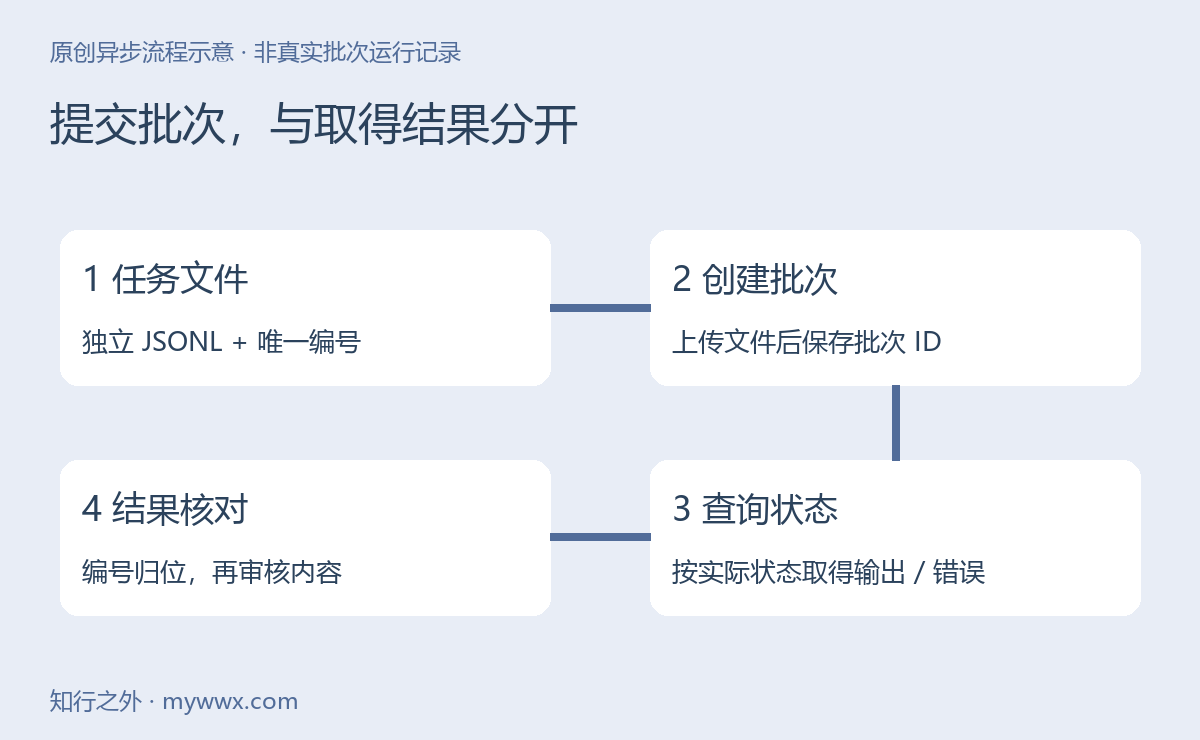
- 开通 API 账号,确认模型权限、计费和批处理额度,设置合适的预算。把密钥放在安全配置中,不写进任务文件或结果记录。
- 生成少量 JSONL,检查每行可以解析,编号唯一,模型和接口一致。保存任务原文及输入文件摘要,便于知道结果来自哪一版。
- 使用 Files 接口上传文件,用途设为
batch,取得文件 ID。文件上传成功不是批次已经创建。 - 调用批次创建接口,提供输入文件 ID、接口路径与完成窗口。当前官方指南的完成窗口使用
24h;不要把这个参数解释为每个请求都固定等待二十四小时。 - 保存返回的批次 ID,再适度查询状态。不要反复创建新批次代替查询,否则可能重复计费和处理同一输入。
- 按实际状态取得输出文件与错误文件,逐条对齐原任务,最后再做内容质量审核。
如果使用 Python 客户端,下面是与当前指南对应的关键调用顺序。它需要真实密钥与已经验证的 tasks.jsonl,本文没有执行这段联网代码。
from openai import OpenAI

client = OpenAI()
with open("tasks.jsonl", "rb") as file:
    uploaded = client.files.create(file=file, purpose="batch")
job = client.batches.create(
    input_file_id=uploaded.id,
    endpoint="/v1/responses",
    completion_window="24h",
)
print("保存批次编号:", job.id)
# 下次使用保存下来的编号查询,不再创建同一批次。
status = client.batches.retrieve(job.id)
print("当前状态:", status.status)
请求失败时先核对返回信息,不把文件 ID、批次 ID 与模型请求 ID 混为一谈。它们分别代表文件、整批作业和具体请求,排错与账单对照时用途不同。
五、为什么必须按编号对齐
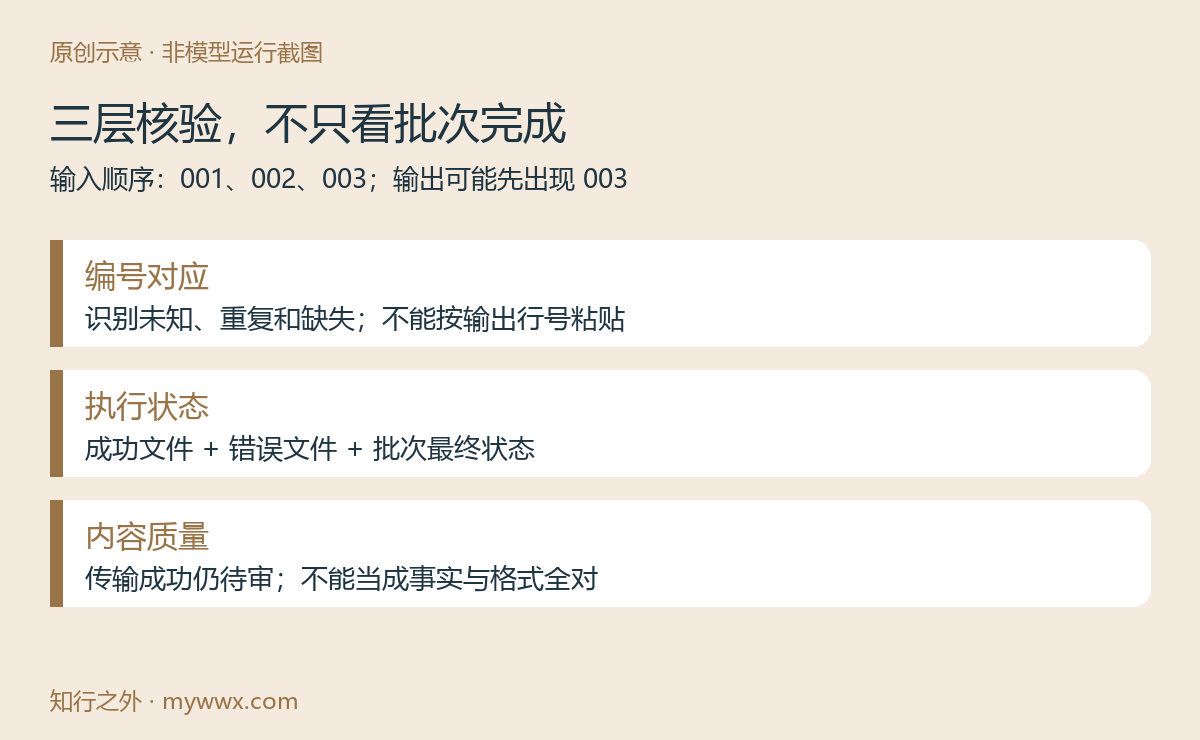
官方指南提醒,输出顺序可能与输入顺序不同。假设输入依次是 demo-001、demo-002、demo-003,下载结果先出现第三条,并不意味着第三条的回答属于第一条。
不能用行号直接把结果贴回原表。应使用 custom_id 建立映射,检查未知编号、重复编号与缺失编号。把编号放进提示词让模型返回,也不如使用接口的结构化关联字段可靠,因为模型文字可能漏写或改写编号。
成功文件并不包含所有失败的请求。错误文件和批次状态同样要检查;某条没有出现在成功文件里,可能在错误文件里,也可能需要结合最终状态进一步核对。一个批次有输出文件,不等于所有任务都成功。
六、用离线练习检查乱序与错误
以下代码只操作内存,不读取密钥、不访问网络。构造的结果故意先返回第三条,再返回第一条,第二条失败。真实使用时,应解析自己下载的成功与错误 JSONL 后,再执行同样的编号检查。
expected = ["demo-001", "demo-002", "demo-003"]
success = [
    {"custom_id": "demo-003", "response": {"status_code": 200}},
    {"custom_id": "demo-001", "response": {"status_code": 200}},
]
errors = [
    {"custom_id": "demo-002", "error": {"code": "demo_failure"}},
]

def reconcile(expected, success, errors):
    if len(expected) != len(set(expected)):
        raise ValueError("输入编号重复")
    allowed = set(expected)
    seen = {}
    for row in success + errors:
        key = row["custom_id"]
        if key not in allowed:
            raise ValueError("结果含未知编号")
        if key in seen:
            raise ValueError("结果编号重复,停止自动合并")
        response = row.get("response") or {}
        code = response.get("status_code")
        ok = (not row.get("error") and isinstance(code, int)
              and not isinstance(code, bool) and 200 <= code < 300)
        seen[key] = "传输成功待审" if ok else "失败待查"
    return [(key, seen.get(key, "缺失待核对")) for key in expected]

for key, state in reconcile(expected, success, errors):
    print(key, state)
预期按原任务顺序显示第一条和第三条传输成功、第二条失败。函数遇到未知或重复编号会停止,而不是悄悄覆盖记录;删除一条结果则显示缺失。本文对这些离线分支进行了检查,但没有验证真实账号、SDK 序列化或模型质量。
“传输成功待审”故意没有叫“内容正确”。即便 HTTP 成功,响应仍可能有不完整、拒绝或不符合任务要求的内容。实际归档还需检查模型响应状态、输出结构和人工验收规则,不要只用这段教学函数替代全部生产处理。
七、重试只处理需要重试的部分
先保留完整原始输入、成功文件、错误文件、批次 ID 与对应关系,再判断哪些失败适合重试。格式错误要修正输入,权限和额度问题要先处理账号,暂时性错误才考虑有上限的重试。缺失结果要结合批次最终状态检查,不能看到暂时没结果就再次提交。
重试文件仅包含确认需要再处理的任务,并保存它与原编号的映射。可以给每次尝试单独编号,同时保留业务主键;同一条业务内容不能因为两次都返回成功,就在数据库插入两份结果。
过期、取消和失败也不是同一种状态。按官方指南核对已经处理与未处理的部分,能下载的结果先归档。不要把取消理解为瞬间抹掉所有已经发生的请求,更不能靠删除本地文件撤回远端任务。
八、怎样判断值得采用
做一次小规模试验,记录准备时间、等待时间、成功与失败数量、人工复核成本和实际账单。比较的是相同模型、相同任务与同样验收标准下的总成本,不是只看宣传中的单价差。
如果任务需要上下文依赖,可以先把流程拆成独立阶段,完成上一阶段并验收后再生成下一批;不能让同一批的后几行假定已经知道前几行结果。对于每天只有几条、必须立即完成的需求,普通接口可能更容易维护。
第一次真正跑通的标志,是任何一个编号都能解释“成功但待审、失败原因或仍待核对”,并能安全地恢复剩余任务。批处理的价值来自可追踪和可恢复,而不是把请求数堆得足够大。


还没有公开评论,欢迎分享你的想法。