调用 AI 接口时,最容易写出的错误处理是“失败就再试一次”。但超时只表示客户端没有按时拿到结果,不代表服务端没有处理请求;如果生成成功后又写文章、保存文件或创建任务,重试还可能把同一份成果提交两遍。
本文围绕“生成阅读摘要并归档”的虚构任务,区分超时、重试、退避与幂等,再用 Python 标准库做一个不会重复新增归档记录的小练习。示例不调用模型,也不宣称解决了供应商计费或所有分布式一致性问题;目标是先把自己负责的结果保存环节做清楚。
一、把一次任务拆成三个阶段
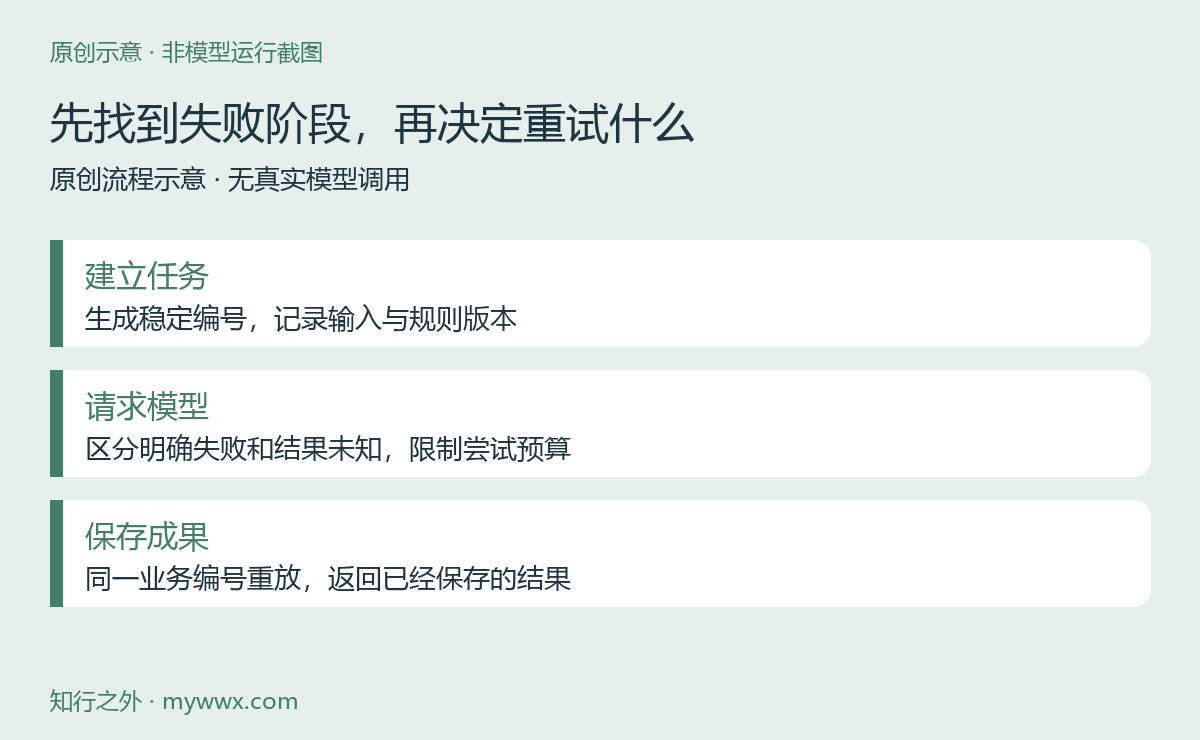
第一阶段读取资料并建立任务编号,第二阶段请求模型生成摘要,第三阶段把经过检查的摘要保存。三个阶段分别失败,处理方式并不相同。不能看到一个红色提示,就把整个流程从头再跑。
例如,模型已经返回摘要,数据库也已经保存,但页面因网络断开没有收到成功提示。这时重复提交保存请求,应返回此前的记录,而不是再次新增。如果模型调用本身没有返回,则还需要考虑服务端是否已经处理、接口是否支持查询和去重等问题。
把状态至少区分为“未开始”“正在请求”“结果待审”“已保存”“失败待处理”。实际状态数量可以按业务增加,但不要把“结果未知”直接记成“从未执行”。用户刷新页面也不应自动创建另一个新任务。
二、先判断错误是否值得重试
输入字段不合法、密钥失效或权限不足,通常需要修正条件,而不是按原样不断提交。临时网络故障、部分服务端错误或限流可能允许稍后再试,但要以实际服务的错误说明为准,不能把所有客户端错误和服务端错误各自一刀切。
如果接口返回等待时间或重试建议,应按官方规则解释并结合总等待预算处理。没有这些信息时,也要设置最大尝试次数与整项任务截止时间。长请求被一个过短的统一超时反复打断,可能比适当等待更浪费资源。
一份便于处理的问题记录应包括任务编号、发生阶段、错误类别、尝试次数与下一步。不要在日志里打印密钥、完整私人材料或未脱敏的模型输入。能定位故障不等于必须公开所有原文。
三、退避与抖动解决的是请求节奏
退避是在两次尝试间等待,指数退避让等待上限逐渐增长,并通常设一个最大上限。抖动是在等待中加入随机变化,减少大量客户端恰好同一时刻再次请求。AWS 官方工程文章解释了这些方法,也提醒重试可能放大服务负载。
可以把一个教学计划设为:首次失败后最多等一秒,下一次最多等两秒,再下一次最多等四秒,并在各自范围内选择等待时间。这只是示例配置,不是所有模型服务的推荐参数;实际值要结合延迟、限额、官方要求与用户可接受等待时间确定。
退避不能防止重复创建记录,幂等也不能替代限流。前者调整请求节奏,后者限制相同业务意图重复产生副作用。把等待加长,并不会让一个重复发布接口突然变成安全的接口。
还应检查 SDK 是否已有自动重试。如果 SDK 尝试三次,业务外层又完整重跑三次,实际请求可能超过你以为的次数。需要看清哪些层负责重试、尝试次数如何计算,避免每层都“热心地再试一下”。
四、幂等键表达的是同一次业务意图
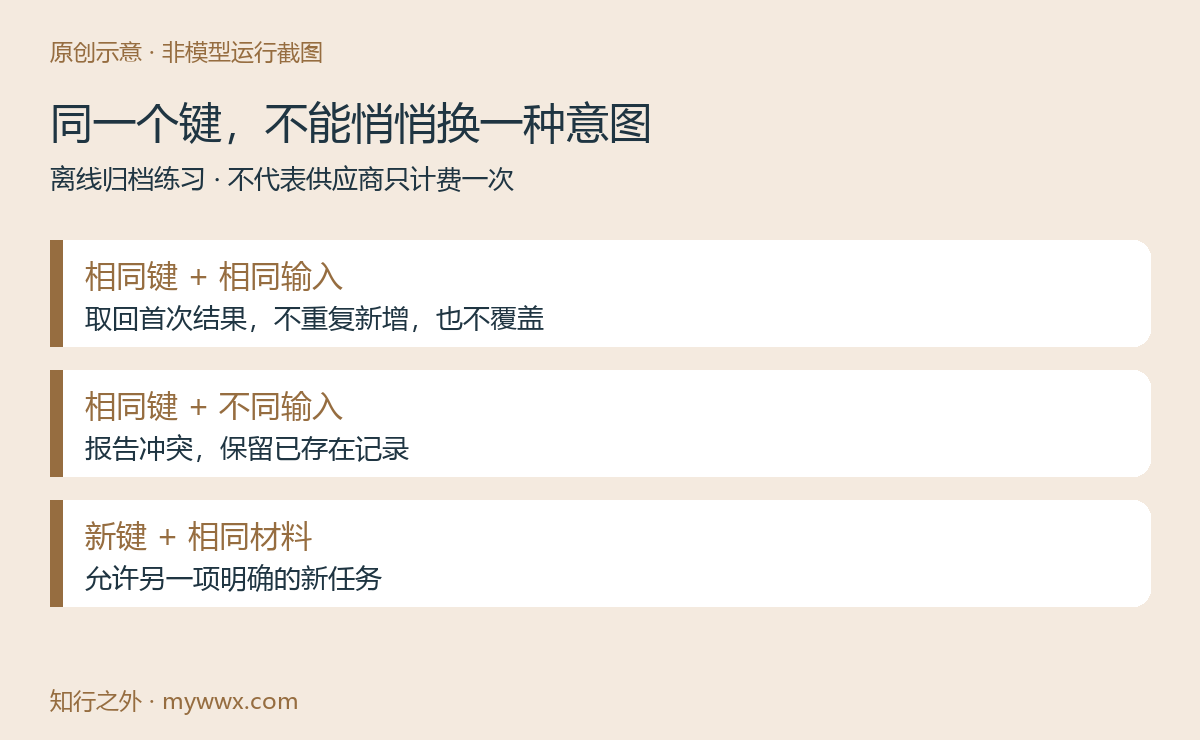
对于同一个任务的保存重试,使用同一个任务编号作为幂等键;当用户明确要求生成另一版摘要时,应建立新任务编号。即使两次资料完全一样,也可能是用户主动要求两个独立版本,不能只看文字哈希就全部合并。
另一方面,同一个键却对应不同资料,应拒绝或提示冲突,不能悄悄拿旧结果当新资料的摘要。任务编号用于表达意图,输入摘要用于检查参数是否被误改,两者职责不同。
真实系统还需要把账号或项目范围纳入唯一性约束,防止不同用户的编号互相碰撞。下面为了便于理解只使用一个内存数据库,不提供多用户授权、后台队列和线上发布接口,也不应直接拿去替换生产系统。
五、准备一个可以离线运行的保存练习
本例使用 Python 自带的 sqlite3、hashlib 和 json,不安装模型 SDK。先建立一个独立目录,将下面代码保存为 archive_demo.py,再用自己的 Python 解释器运行。内存数据库只在进程中存在,退出后不会保存练习数据。
import sqlite3
import hashlib
import json

def fingerprint(payload):
    raw = json.dumps(payload, ensure_ascii=False, sort_keys=True,
                     separators=(",", ":"))
    return hashlib.sha256(raw.encode("utf-8")).hexdigest()

def store_result(db, task_id, payload, summary):
    if not task_id.strip() or not summary.strip():
        raise ValueError("任务编号和摘要不能为空")
    digest = fingerprint(payload)
    with db:
        db.execute("BEGIN IMMEDIATE")
        old = db.execute(
            "SELECT fingerprint, summary FROM archive WHERE task_id=?",
            (task_id,),
        ).fetchone()
        if old:
            if old[0] != digest:
                raise ValueError("同一任务编号对应不同输入")
            return False, old[1]
        db.execute(
            "INSERT INTO archive(task_id,fingerprint,summary) VALUES(?,?,?)",
            (task_id, digest, summary),
        )
        return True, summary

if __name__ == "__main__":
    db = sqlite3.connect(":memory:")
    db.execute("CREATE TABLE archive (task_id TEXT PRIMARY KEY NOT NULL, "
               "fingerprint TEXT NOT NULL, summary TEXT NOT NULL)")
    payload = {"material": "虚构阅读材料", "prompt_version": "v1"}
    print(store_result(db, "task-demo-01", payload, "人工编写的示例摘要"))
    print(store_result(db, "task-demo-01", payload, "重复请求携带的新草稿"))
    print(db.execute("SELECT COUNT(*) FROM archive").fetchone()[0])
    db.close()
首次保存返回已创建和示例摘要;第二次使用同一任务编号与输入,应返回未新建和第一次保存的摘要;最后总记录数应为一。这些文字是程序的确定性练习预期,不是一次模型生成质量测试。
这里把提示词版本纳入输入记录。真实任务中,模型标识、资料版本、生成设置等凡是会改变任务含义的字段,也应按业务约定纳入检查。不要因为省略了某个关键字段,让一个已经变化的任务误用旧成果。
六、为什么检查与保存要放在同一事务中
如果先查“没有记录”,过一会儿再写入,两个并发请求可能都看到不存在。唯一约束提供最后防线,事务则帮助把检查和保存组织成一个整体。示例在保存段开始写事务,出现参数冲突时回滚,不留下半条结果。
但事务里不应该等待漫长的模型请求。先在适当的任务状态控制下取得待审核结果,再进入短小的本地保存事务;把远程调用放在数据库写锁里,会影响其他操作。完整的任务调度需要另行设计,本文只演示保存阶段。
同一个键重复到达时返回已保存结果,有助于调用者确认“这次请求对应的成果是什么”。如果仅返回“重复了”却不提供记录线索,前端仍可能误以为失败,再创建另一项任务。
七、用四个反例检查边界
先把输入字典的字段顺序颠倒,内容保持相同,预期仍识别为同一输入;再修改材料但保留任务编号,预期报冲突且记录数不变。随后使用新编号保存相同材料,预期允许建立另一条记录,因为业务意图已经不同。
再模拟“保存成功后,客户端没有收到确认”:不删除数据库记录,只重放相同编号与输入。应取回第一次保存的摘要,不把第二份草稿覆盖进去。这个练习模拟的是结果保存重放,没有真的切断网络,也没有模拟供应商处理中的请求。
还要测试空任务编号和空摘要,避免把无效结果标记为已完成。若真实服务需要允许空摘要,应把“没有内容”设计成明确状态和原因,而不是无区别地放过空字符串。
八、这段代码保护不了哪些事情
示例无法阻止在保存前就发出的两次模型调用,也不保证供应商只计费一次。若供应商没有明确支持幂等请求或结果查询,客户端自己加一个同名请求头并不会自动获得这些能力。应该查证目标服务的具体接口约定,而不是从别家 API 推断。
数据库里有一条归档,也不代表外部系统只创建一篇文章。如果后续发布到另一个服务,需要那个环节的任务标识、确认记录或可恢复的交付设计。跨系统操作不能靠一个本地事务全部包住。
持久化系统还要考虑幂等记录保留时间、过期重试、失败恢复与并发权限。清除记录后迟到的旧请求可能再次执行,因此清理策略必须与业务可接受的重复窗口一致,不能随意定一个很短的缓存时间。
九、把排错清单带回自己的 AI 应用
下次发生失败时,先问错误位于模型请求还是结果保存,结果是明确失败还是未知;再确认有没有已有记录可查,重复请求是否复用了同一个业务编号。只有知道哪一步需要补做,才决定重试哪一步。
把尝试次数、总等待预算和人工处理入口写在任务说明里,超过预算就留下可恢复状态,不让后台无限循环。对普通用户而言,一个能说明“已生成、待保存”的界面,比一遍遍显示“失败,请重试”更容易正确操作。
这次练习完成后,应能解释退避管节奏、幂等管副作用,以及为什么超时不等于从未执行。先用简单的归档例子建立判断,再扩展到需要联网和发布的流程,能减少重复成果和难以追踪的重跑。


还没有公开评论,欢迎分享你的想法。