做知识库问答时,用户输入准确的产品编号,系统却找到一篇意思相近的介绍;换成口语提问,又只匹配到了几个相同字词。两种现象说明:关键词匹配与语义相似各有擅长的部分,不能把其中一种当成所有问题的答案。混合检索尝试把不同检索路径的候选结果合成一份排序。
本文用四条原创的设备借用资料解释混合检索与 RRF 排名融合。你只需要纸笔或 Python,就能复算一份排序,不需要购买向量数据库或调用模型。示例中的两份候选排名由人工设定,目的是演示融合算法,不冒充真实 BM25 或嵌入模型的检索效果。
一、先看两种检索在做什么
关键词检索利用词项及其在文档中的信息找匹配,适合保留设备型号、错误码、专有名词等明确线索。BM25 是常见的文本相关性计算方式之一,但本篇不实现中文分词或完整 BM25;实际效果还受字段、分析器和语料影响,不能简单理解成“重复关键词次数最多就第一”。
向量检索将问题和资料表示为向量,再按某种相似度找近邻,可以帮助关联不同表述。例如“机器借走后几时还”与“设备归还期限”字面不完全一致,却可能表达相近需求。它仍然可能混淆型号、否定条件或相似流程,距离近不等于规则适用。
混合检索让这两类路径都参与候选召回,再用某种融合方式排序。它不是先把全部资料交给大模型,再让模型随意挑选。 检索、排序和最终回答是不同环节,定位错误时也应分别观察。
二、准备四条编号稳定的练习资料
下面是虚构的内部设备借用说明,每条先赋予稳定编号,便于比较同一篇资料在不同榜单中的位置:
- D1:设备 A17 仅供当天使用,借用当天归还;延期需管理员另行确认。
- D2:一般设备借用期限为三天,具体设备的专门规定优先。
- D3:设备 A17 的故障申报应填写资产编号与现象。
- D4:会议室预约的取消规则与设备借用无关。
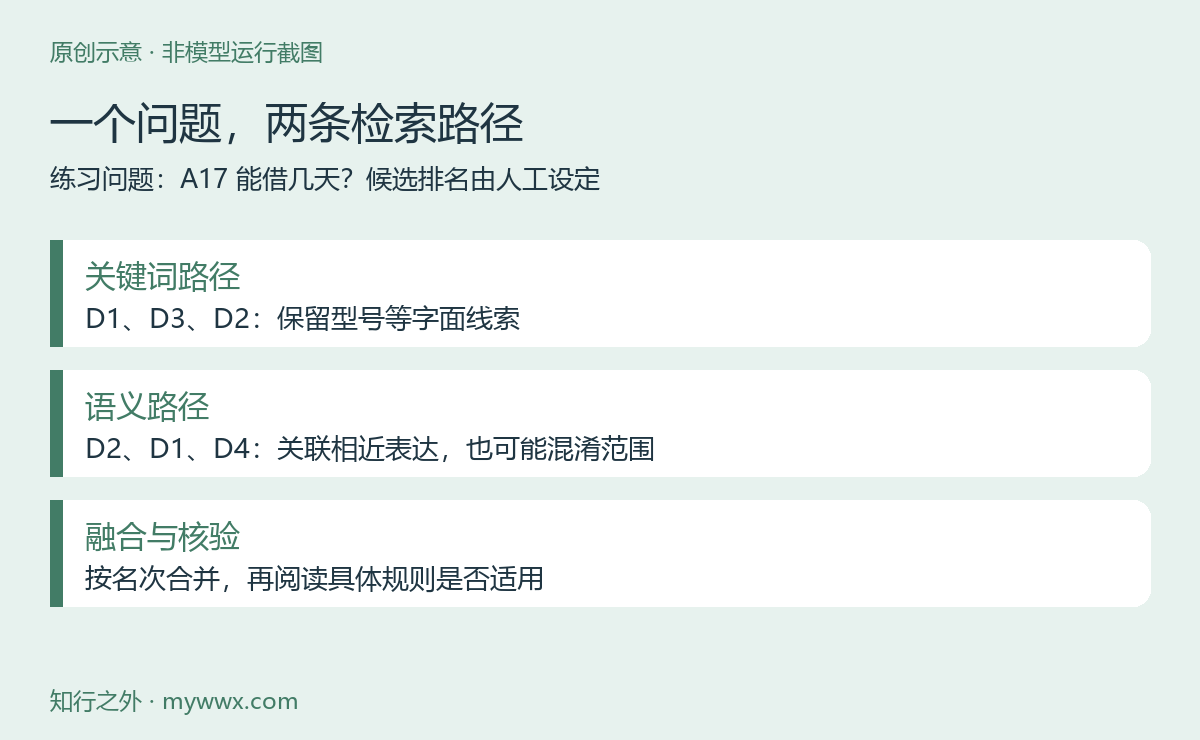
用户问题是:“A17 能借几天?”正确答复需要识别具体型号,并读懂专门规定优先于一般规定。D3 虽然包含 A17,却在讲故障;D2 虽然讲期限,却不能直接覆盖 D1。这个小数据集故意保留容易混淆的候选,避免用完全无歧义的材料展示虚假的完美效果。
真实项目需要保存资料来源、适用范围、版本和权限。本例没有真实人员信息,也没有把这些规则当成现实中的借用制度。练习完成后,不应把虚构条款复制给用户作为正式承诺。
三、先分别观察两份候选榜单
人工设定关键词路径返回 D1、D3、D2,语义路径返回 D2、D1、D4。每份列表从左到右表示从第一名到第三名。这里只使用名次,不虚构原始检索分数。
关键词榜单让包含 A17 的 D1 和 D3 靠前,体现字面线索的作用;语义榜单把一般借用期限 D2 排在前面,体现主题相近也可能把泛化资料推高。这些只是教学设定,不代表任何具体产品必然产生相同顺序。
如果只看关键词第一名,可能没有发现故障资料混在前排;如果只看语义第一名,可能误答三天。先保存两条路径各自的结果,再评估融合是否改善,更容易解释问题。不要只展示融合后的漂亮列表,把失败候选藏起来。
四、为什么不能直接把原始分数相加
不同检索方式的分值含义与范围可能不同。一个榜单给出十几分,另一个给出零点几,直接相加就可能让数值尺度较大的路径主导结果。把它们随意换算成百分制,也不自动保证两个分数具备可比的业务意义。
一种常见思路是只用名次进行融合,RRF 就属于这一类。它不要求两条路径的原始分数使用同一个尺度,但仍依赖候选本身的质量。原来没有被任何路径找出的关键资料,不会因为融合公式而凭空出现。
Elastic 官方文档将混合检索描述为合并全文与向量检索,并介绍了 RRF。本文借此解释通用机制,不声称已部署 Elasticsearch,不提供未经测试的服务端配置,也不把官方某个实现的所有默认值当作所有系统的标准。
五、用 RRF 逐条算一次
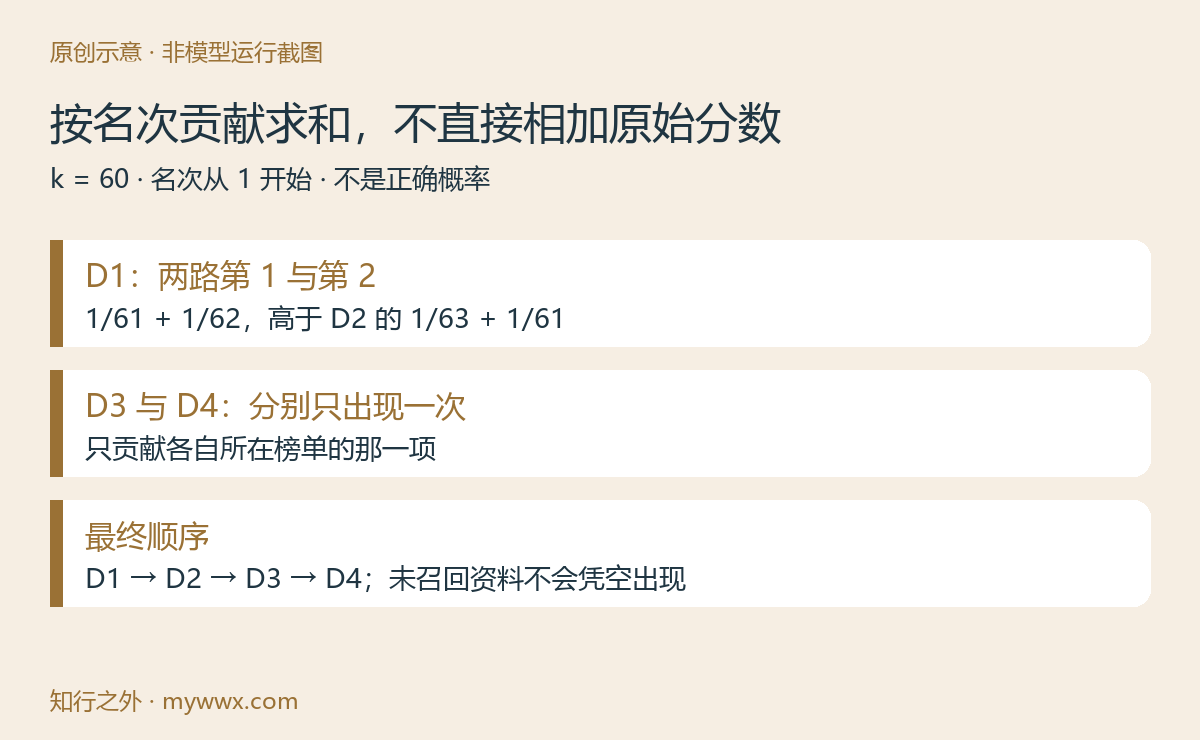
对每条资料,在出现它的每个榜单中加入一项 1 / (k + 名次),然后求和。名次从一开始,未出现在某份候选列表中就不加入那一项。本例使用 k 等于六十,便于对照官方常见参数说明;它不是必须照抄的业务最优值。
D1:关键词第1 + 语义第2 = 1/61 + 1/62
D2:关键词第3 + 语义第1 = 1/63 + 1/61
D3:只有关键词第2       = 1/62
D4:只有语义第3         = 1/63
D1 与 D2 都在两份榜单中出现,累积贡献高于仅出现一次的资料。D1 最后略高于 D2,融合顺序为 D1、D2、D3、D4。融合分数表示这套排序规则下的相对顺序,不是“答案正确概率”。 不能把零点零三写成百分之三的可信度。
六、离线运行一个可复算的小程序
把下面代码保存为 rrf_demo.py,使用可用的 Python 运行 python rrf_demo.py。代码仅处理手工列表,不联网、不生成向量、不安装数据库,也不会读取本机文档。
from collections import defaultdict

def fuse(rankings, k=60):
    scores = defaultdict(float)
    for ranking in rankings:
        if len(set(ranking)) != len(ranking):
            raise ValueError("同一路候选不能重复同一资料编号")
        for rank, doc_id in enumerate(ranking, start=1):
            scores[doc_id] += 1 / (k + rank)
    return sorted(scores.items(), key=lambda x: (-x[1], x[0]))

keyword = ["D1", "D3", "D2"]
semantic = ["D2", "D1", "D4"]
for doc_id, score in fuse([keyword, semantic]):
    print(doc_id, f"{score:.6f}")
程序按分数降序排列,同分时按资料编号排序,这是为了练习可重复而定义的规则,不宣称所有检索产品采用相同的并列处理。实际运行得到 D1、D2、D3、D4,与手算一致。这个结果只验证了这份手工输入的计算,不证明混合检索在真实语料上的质量提升。
七、两个小实验说明融合的边界
第一,把两份列表中的 D1 都删除后再计算。无论怎样调整名次融合,D1 都不会重新出现在结果中。问题在于召回缺失,需要检查资料是否入库、型号分词和查询方式,而不是只改融合参数。
第二,让两条路径都把无关资料 D4 排在第一,再观察它的位置。共同出现且都靠前会增加融合贡献,但并不能让会议室取消规则变成设备借用规则。这说明两条路径可能共享错误,融合不是内容正确性的替代品。
真实评估应包含精确型号、口语表达、否定条件、一般规则与例外等问题,保留相关资料标注。先比较单路,再比较融合,用一致的候选数量与问题集复查;不要为了表现提升,只挑融合恰好获胜的一道题。
另一个容易忽略的变量是候选窗口。若每一路只保留第一名,系统只看得到 D1 和 D2;窗口扩大后,D3 与 D4 才有机会参与融合。窗口变化会改变参与打分的资料范围,因此比较两次结果时,需要同时记录每一路取了多少候选,不能只记录最终展示三条还是五条。
同一份资料在不同路径中的编号也必须能够对应。若一路使用原始文档编号,另一路使用分块编号,应先确定融合单位是整篇文档还是段落,再制定映射与去重规则。否则同一条规则可能被重复展示,或者不同段落被错误合并。本文代码要求每一路编号不重复,但并没有替实际系统实现文档与分块的映射,这部分需要应用自己完成。
遇到融合结果并列时,先确认产品如何处理并列,再决定业务排序要求。不要依赖某次偶然的返回顺序,更不要为了让测试通过而事后挑一个喜欢的答案。固定语料、候选窗口和并列规则,才能让一次排查被其他人复算。
八、接入知识库前的检查顺序
首先核对资料本身:版本是否有效,具体规则和一般规则是否分开表达,过期资料是否还在候选中。其次看各路召回:关键资料出现没有,过滤条件是否一致,资料编号是否稳定。最后才看融合名次和生成回答。
权限过滤不能等到答案生成后才补。用户无权阅读的资料,不应因为语义相近进入可展示的候选证据;两路检索都要使用正确的可见范围。融合不是访问控制工具,也不能靠删掉答案中的敏感字样来弥补越权检索。
如果最后用大模型生成答案,应要求引用实际适用的条款,并保留冲突与待确认项。本例应解释 A17 当天归还的专门规则,而不是只引用一般设备三天。检索分数再高,也要阅读文本是否真正支持这句话。
完成练习应交付原始资料、两份候选榜单、融合计算、并列规则和失败实验。这样既能说明为什么当前资料排第一,也知道结果不理想时该检查哪个环节,而不是把一切归结为“模型不够聪明”。


还没有公开评论,欢迎分享你的想法。